Patriot AI Matrix™ 全新登場從核心出發,驅動本地 AI 潛能

本地 AI 工具的流暢運行,源自不間斷的資料流動。Patriot AI Matrix 提供即時反應的記憶體頻寬與持續穩健的高速儲存,掃除系統卡頓、加速模型迭代,讓創作與開發流程持續向前推進。

打造專屬配置

入門推薦

入門 AI 配置

適合個人使用者、輕量對話助理與邊緣終端裝置。

實測硬體平台
AMD Ryzen 9 PRO 7945 12-Core
記憶體需求
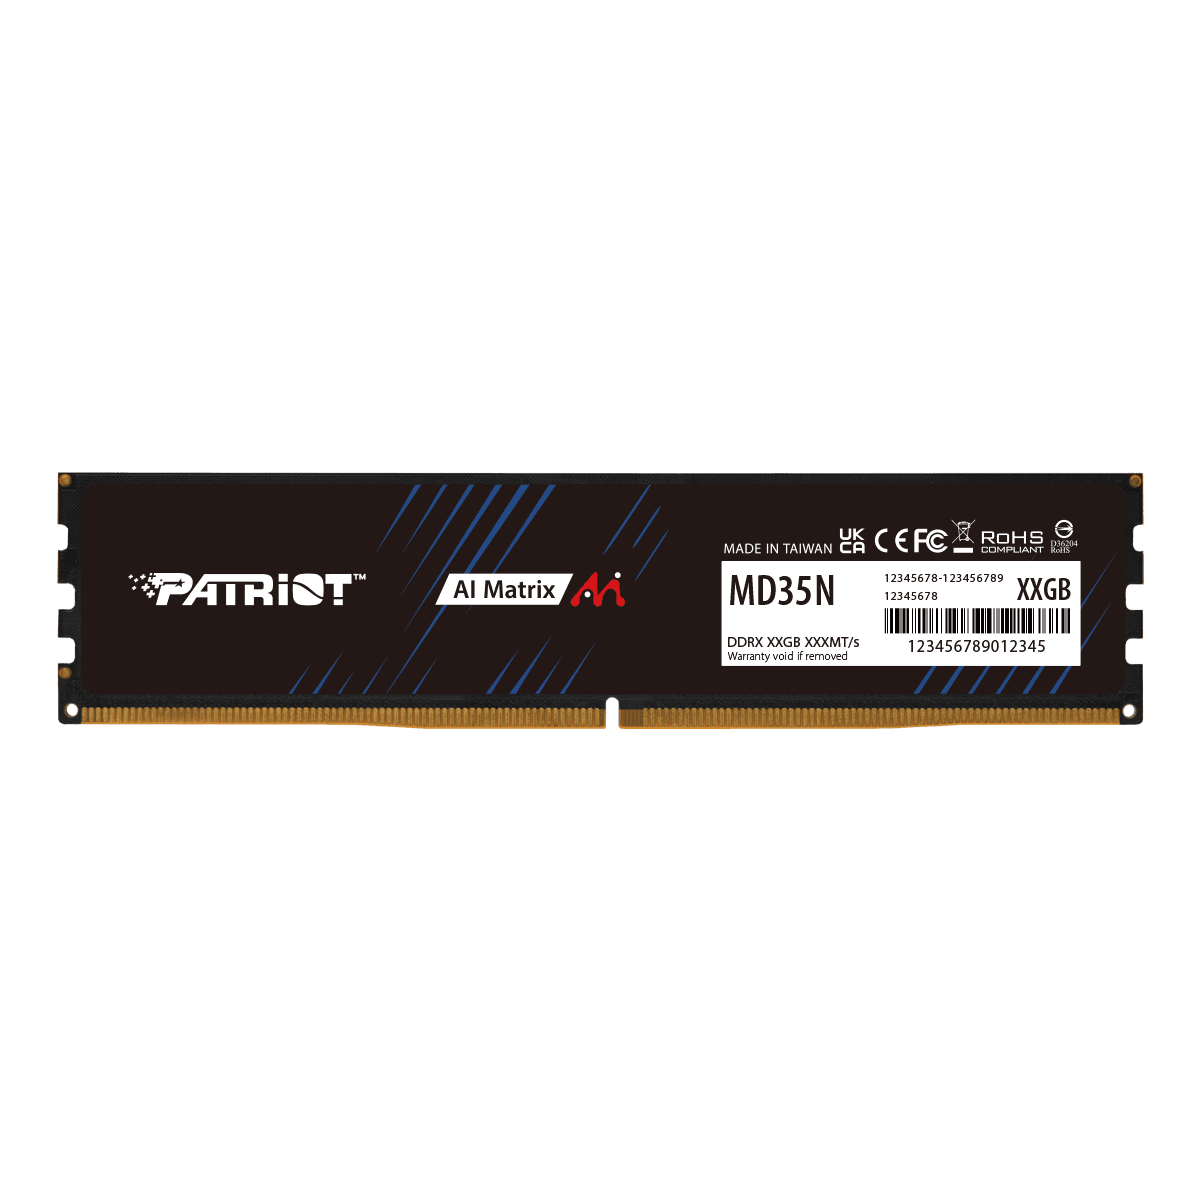
系統記憶體約需 15.7GB,足以流暢運行 8B / 9B 級別模型。
推薦型號: Patriot MD35N DDR5
SSD 儲存需求
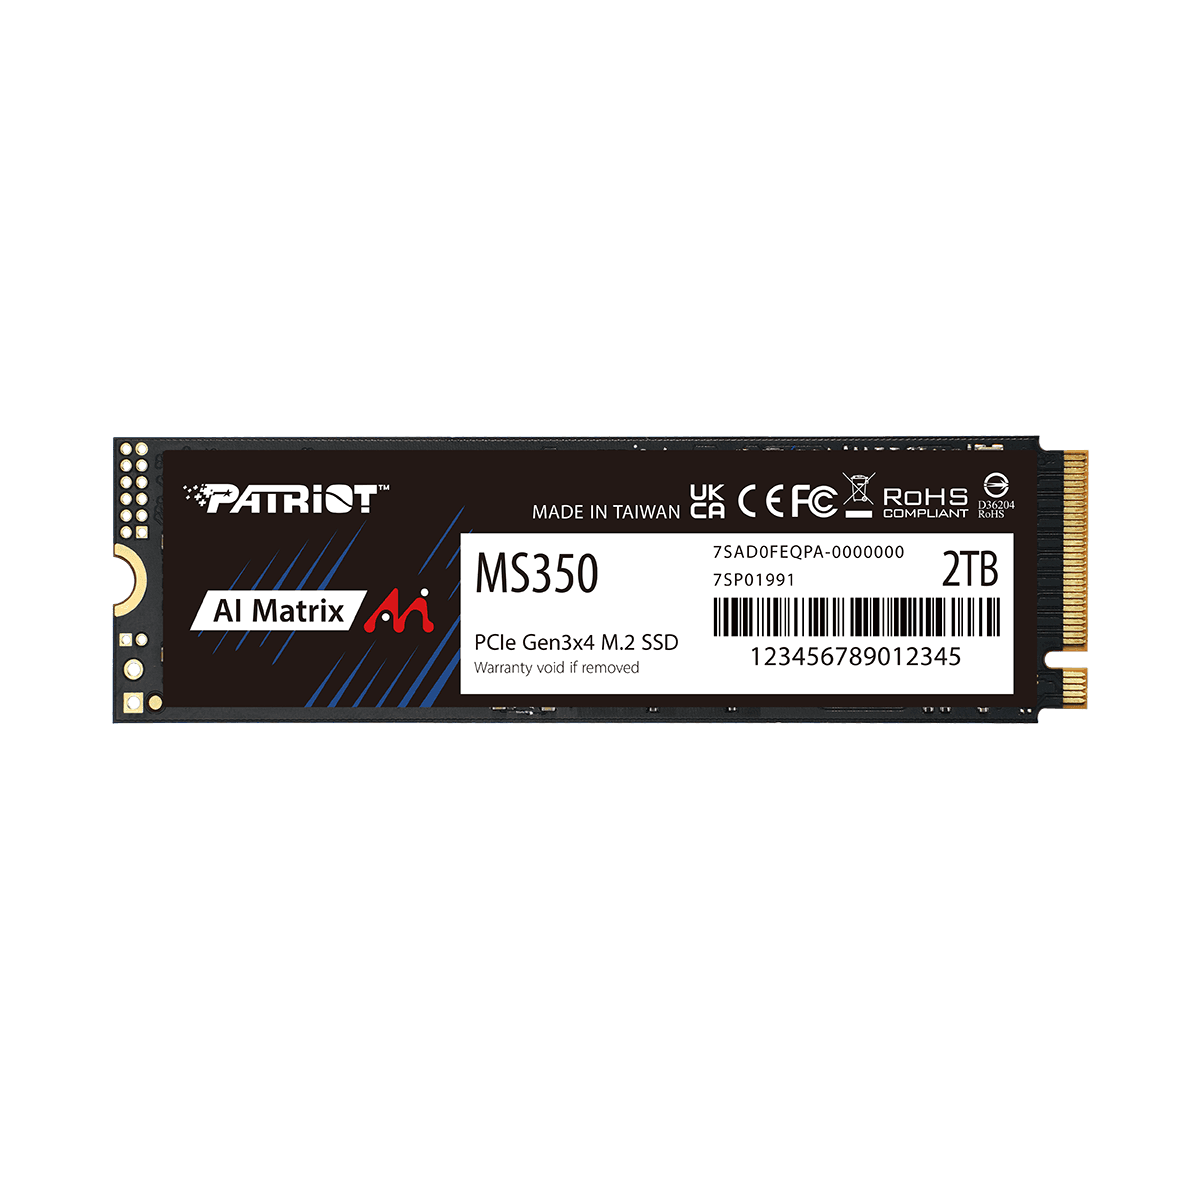
512GB (Gen3 或 Gen4 皆適用)。模型檔案較小,世代傳輸差異體感不明顯,選用最具性價比的容量即可。
推薦型號: Patriot MS350 SSD
支援 AI 任務
8B / 9B 量化模型 (Llama 3.1 8B、Gemma 2 9B)。生成速度達 13–17 tok/s,滿足即時流暢互動需求。
查看入門配置
熱門首選

中階 AI 配置

適合中小企業、部門級部署與開發測試主機。

實測硬體平台
AMD Ryzen 9 PRO 7945 12-Core
記憶體需求
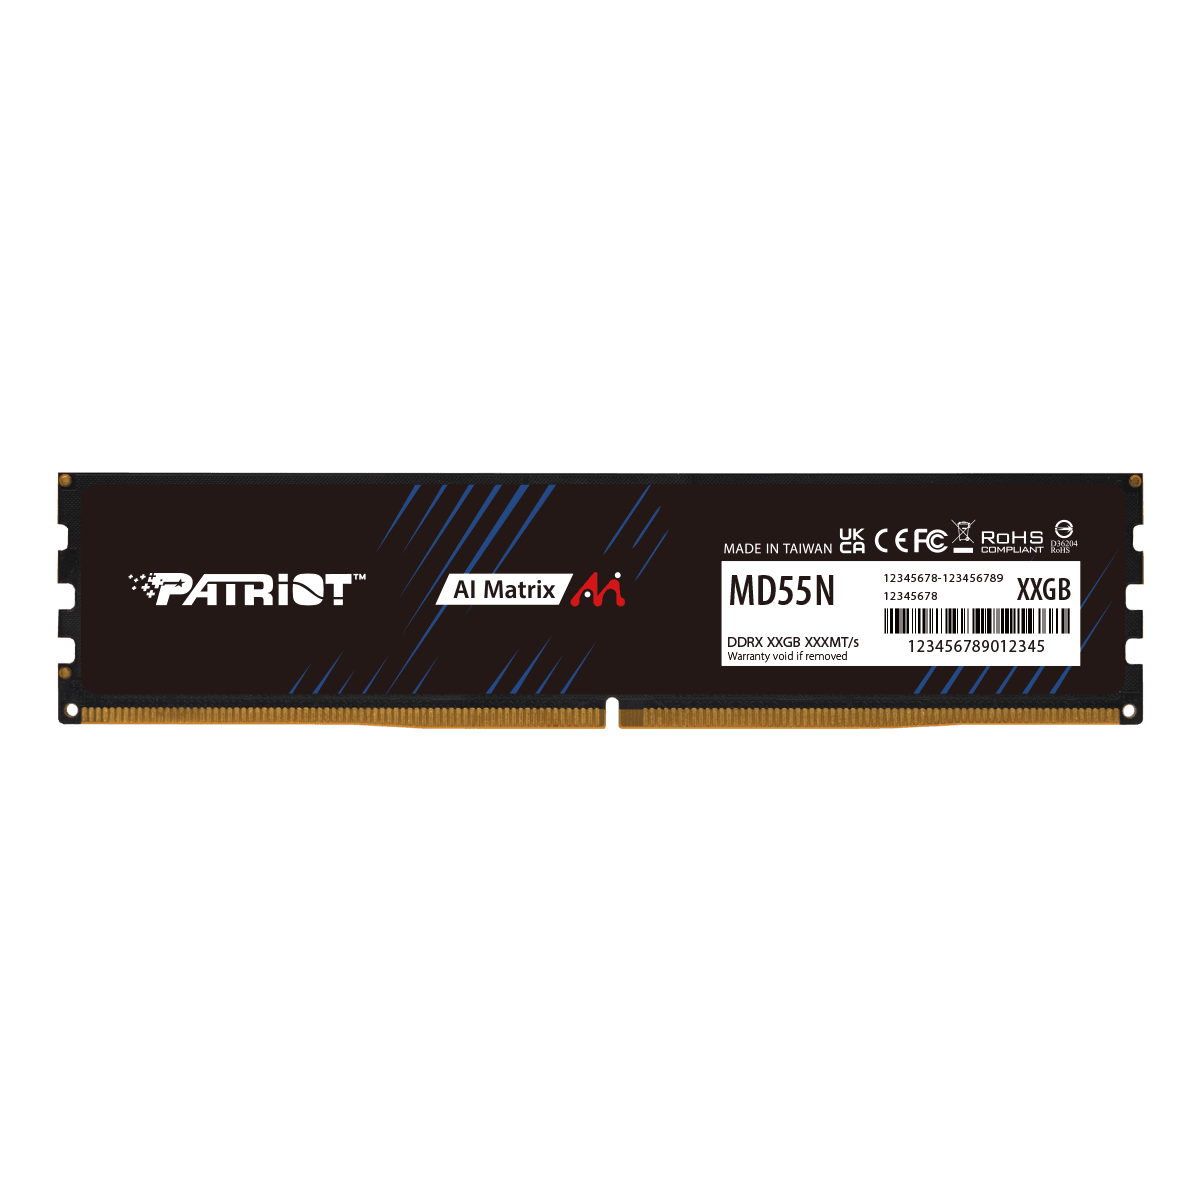
系統記憶體約需 31.2GB,支援最高達 34B 級別模型推論。
推薦型號: Patriot MD55N DDR5
SSD 儲存需求
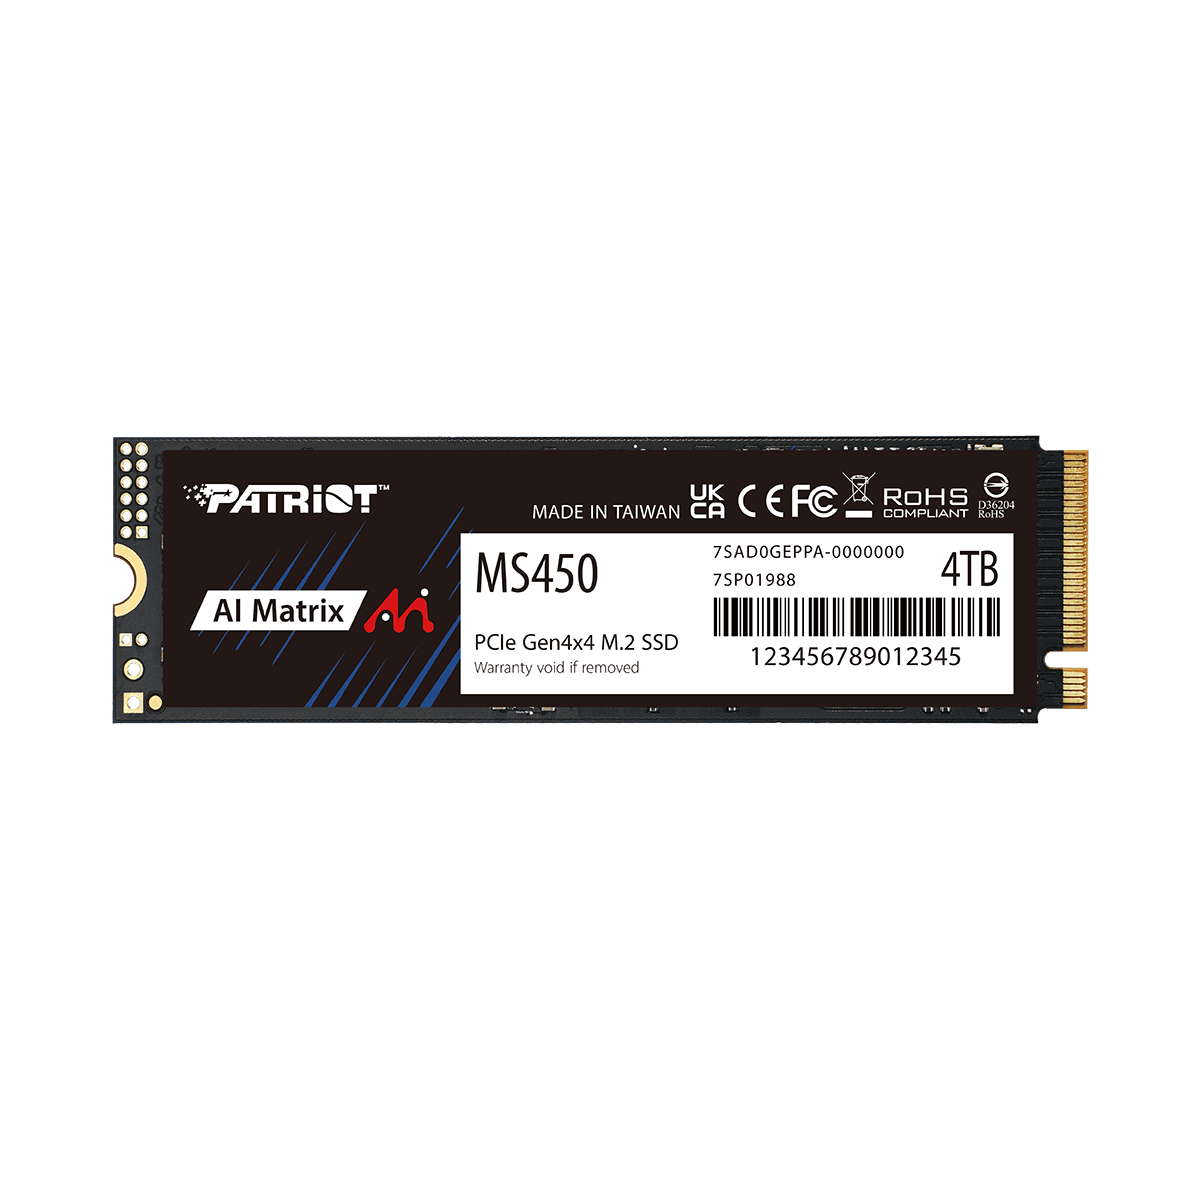
2TB (推薦使用 Gen5)。34B 模型載入實測:Gen4 為 723 秒 vs. Gen3 為 772 秒,大型模型開啟更迅速。
推薦型號: Patriot MS450 SSD
支援 AI 任務
8B / 9B / 27B / 34B 量化模型。8B 與 9B 適合即時互動,27B 與 34B 則適合批次處理任務。
查看中階配置
工作站旗艦

專業 AI 工作站

適合企業級部署、AI 開發者與專業工作站環境。

實測硬體平台
AMD Threadripper PRO 9965WX 24-Core
記憶體需求
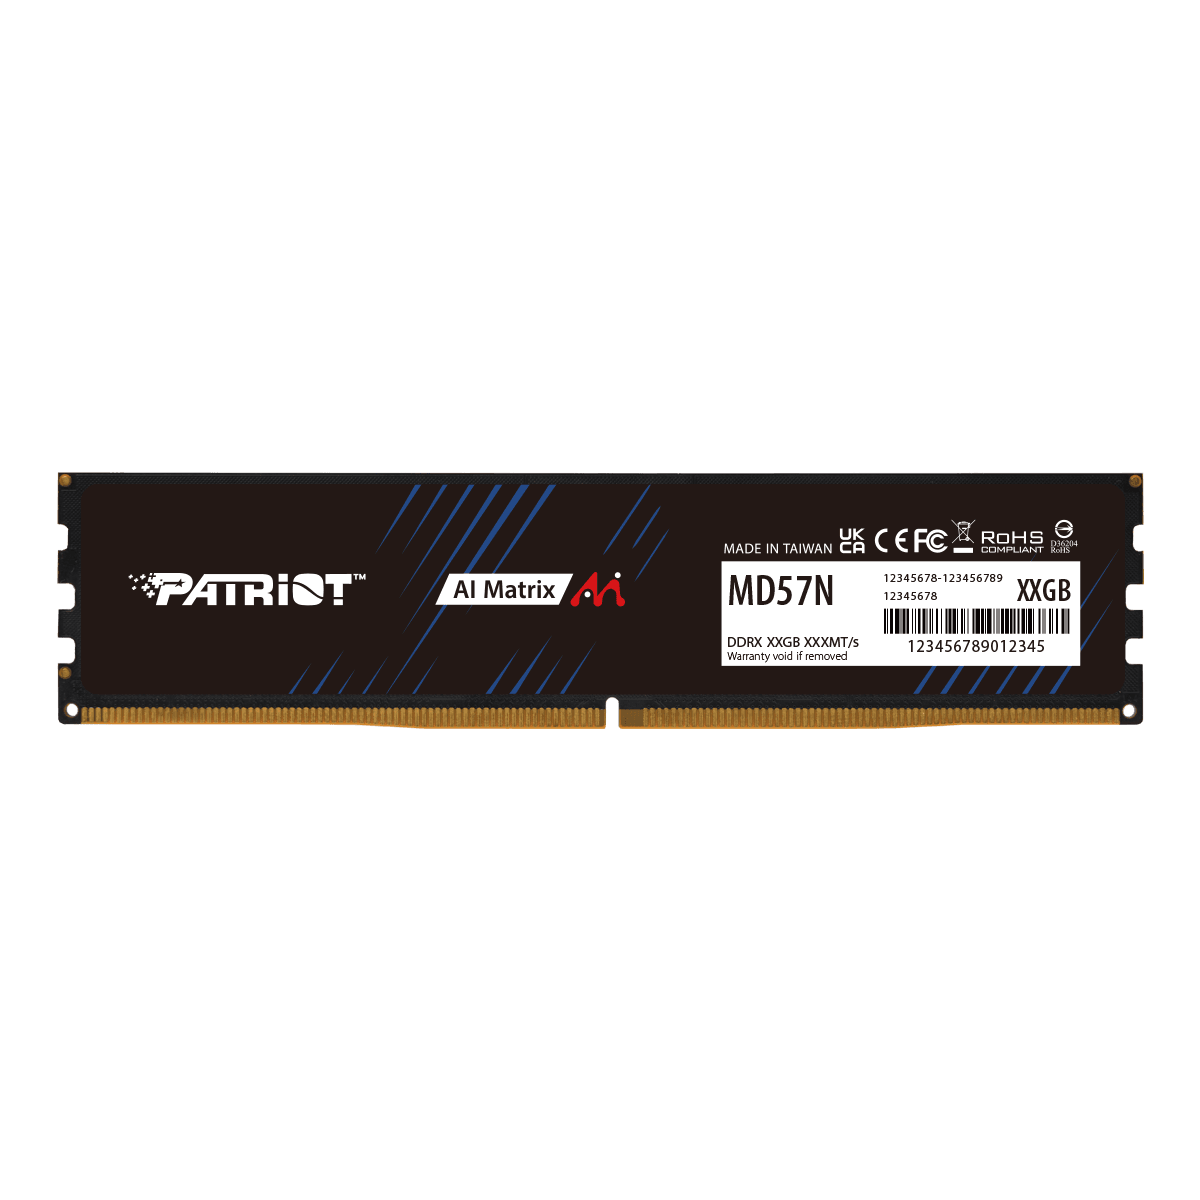
系統記憶體約需 71.4GB,全面支援 70B 級別大型模型。
推薦型號: Patriot MD57N DDR5
SSD 儲存需求
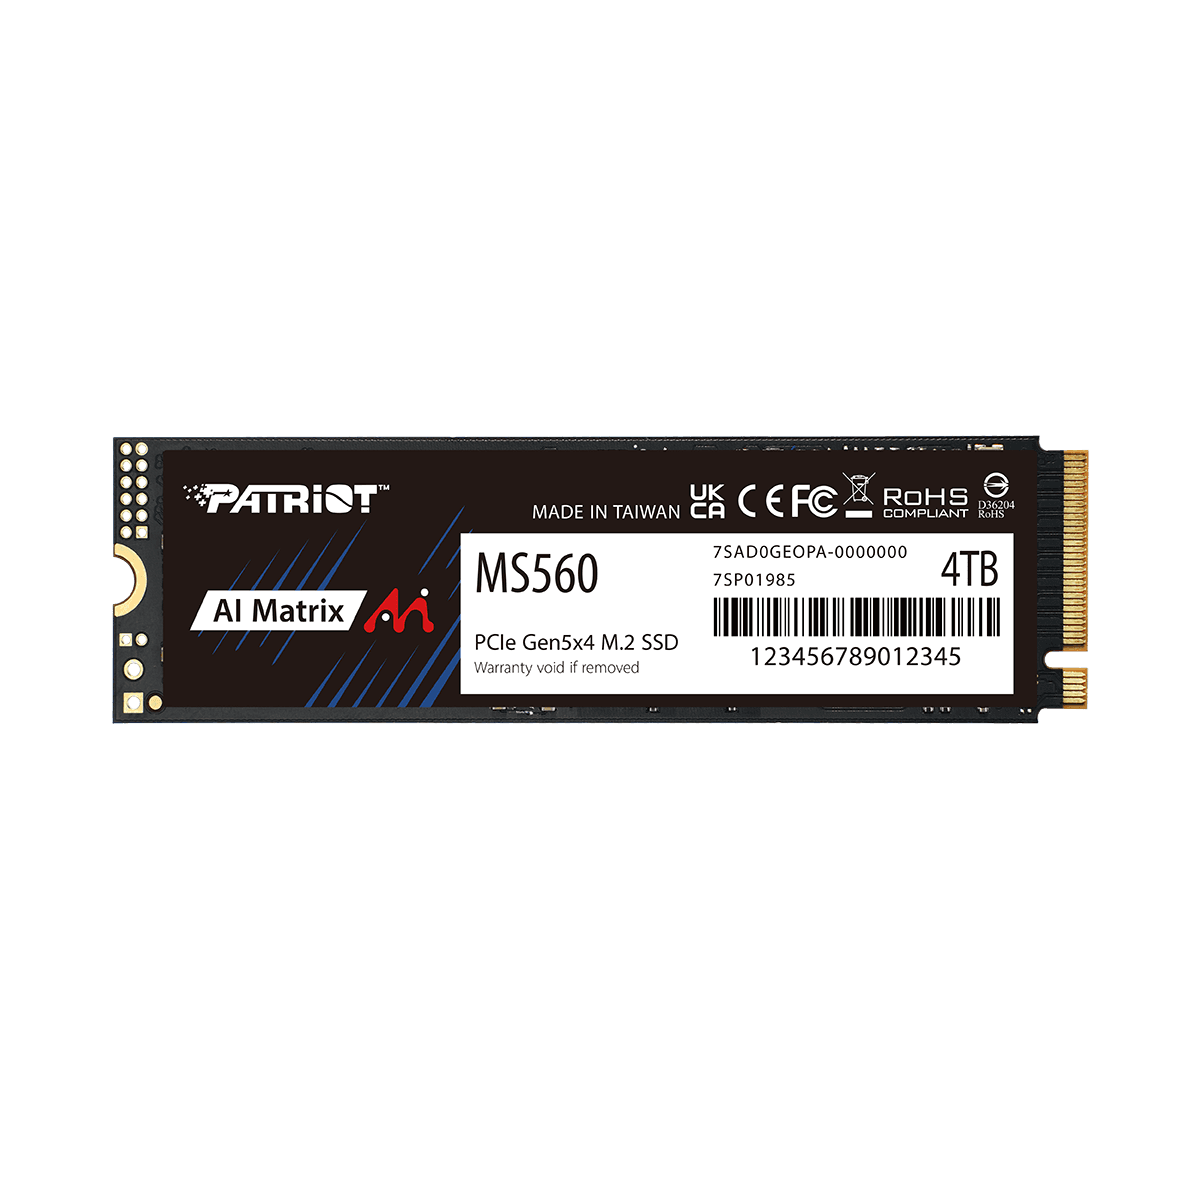
4TB (推薦使用 Gen5)。70B 模型載入實測:Gen5 為 1072 秒 vs. 同容量 Gen3 為 1177 秒,開啟提速超過 100 秒。
推薦型號: Patriot MS560 SSD
支援 AI 任務
支援 8B–70B 全系列模型 (均通過實機測試驗證)。具備 70B 旗艦模型推論、企業級 RAG 知識庫檢索與高複雜度任務處理能力。
查看高階配置

實戰效能數據

不同模型規模的效能表現

Entry

全平台支援

模型載入時間

秒 · 越低越好
Gen5 SSD: MS560141.8 秒
Gen4 SSD: MS450152.5 秒
Gen3 SSD: MS350158 秒

CPU Offload 語言生成速度

每秒 Token 數 · 越高越好
MD57N · 48G12.59 tok/s
MD55N · 32G9.19 tok/s
MD35N · 16G5.44 tok/s

Patriot AI Matrix 系列產品

為何選擇 Patriot AI Matrix

為本地 AI 架構而生

本地 AI 運算能否順暢執行,關鍵在於儲存裝置與系統記憶體之間同步且無礙的資料傳輸路徑。

精準對應的記憶體與儲存配置

Patriot AI Matrix 將高頻寬 DDR5 與極速 NVMe 儲存深度整合,精準對應不同級別的模型需求——從入門級的架構探索,到極致嚴苛的 70B 參數模型推論皆能全面涵蓋。

滿足各種 AI 工作負載

藉由模型秒級載入、長時穩態不降速,以及高頻記憶體卸載支援,各項專屬硬體配置能確保您的本地模型部署更迅速、運作更穩定冷靜,並讓關鍵資料始終完全由您自主掌控。

客製化選擇器

推薦組合

入門 · 7B–14B

DRAM
MD35N · 16GB · 4800MT/s
SSD
MS350 · 512GB
查看配置

AI Matrix 產品總覽

DRAM / SSD 產品總覽

產品容量 / 規格模型範圍料號
MS5604TB / 2TB / 1TB70B–72B7SP01487 / 7SP01531
MS4504TB / 2TB / 1TB27B–34B7SP01836 / 7SP01830
MS3502TB / 1TB / 512GB7B–14B7SP01885 / 7SP01835 / 7SP01834
SSD

SSD 產品規格表

查看 AI Matrix SSD 系列產品規格。

下載 PDF
DRAM

DRAM 產品規格表

查看 AI Matrix DRAM 系列產品規格。

LLM 模型介紹

即時對話助理(7B–14B)

生成速度達 13–17 tok/s,相當於每秒約 15–20 個中文字,支援 AI PC 個人助理、客服與邊緣裝置的即時互動。

程式碼生成與中型推理(27B–34B)

提示詞處理速度每秒達 37–42 tokens,支援企業內部程式碼助理、合約審查等專業用途的特定模型。

深度推理與複雜決策(70B)

70B 大型模型可在離線邊緣環境中提供高精準度分析,適用於重視隱私的工業運算與醫療診斷。

推薦組合

入門

7B–14B

DRAM

MD35N

16GB · 4800MT/s

SSD Q4

MS350

  • 4K上下文512GB
  • 16K上下文1TB